外观
8.智能客服的FAQ匹配算法优化
来源:语雀原文 | 整理日期:2026-09-22
一、答题思路
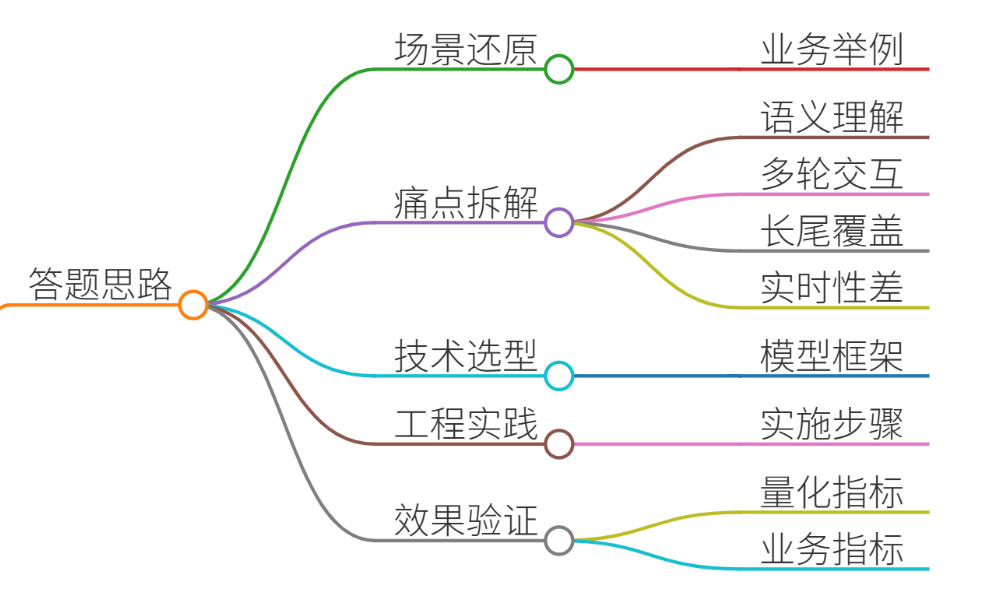
智能客服的FAQ匹配算法优化是提升客户服务效率的核心环节。在面试中回答此类问题时,需结合具体项目案例,从场景分析→痛点挖掘→技术方案→效果验证的逻辑链展开,突出技术深度与业务价值的结合。以下为结构化思路:
- 场景还原:选择具有代表性的业务场景(如电商、金融、电信等),描述智能客服的实际应用环境。
- 痛点拆解:从语义理解、多轮交互、长尾覆盖、实时性等维度分析现有FAQ匹配算法的不足。
- 技术选型:结合业务需求选择合适的算法框架(如BERT、知识图谱、强化学习等)。
- 工程实践:分步骤说明数据标注、模型训练、部署优化等实施细节。
- 效果验证:通过量化指标(准确率、召回率、响应时间)和业务指标(客户满意度、首解率)证明优化效果。
二、项目案例
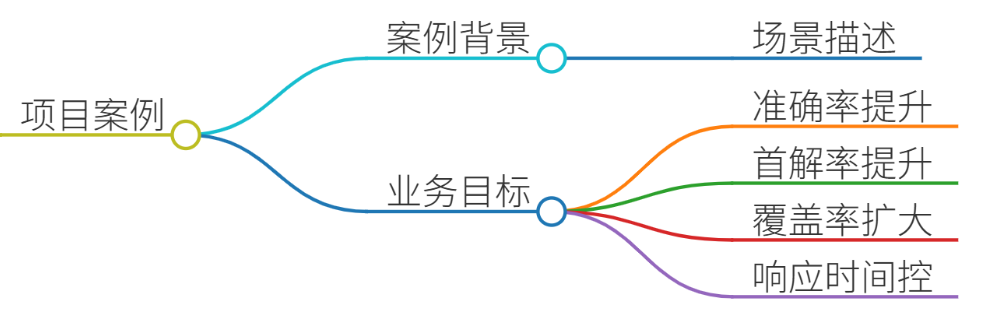
案例背景:某电商平台智能客服系统FAQ匹配优化
场景描述:
该电商平台日均订单量超百万,用户咨询量巨大,传统基于关键词匹配的FAQ系统存在以下问题:
- 语义理解不足:用户提问存在口语化表达、同义表述差异(如“订单取消” vs “退款”),导致匹配准确率仅65%。
- 多轮交互缺失:用户需多次追问才能得到完整答案,首解率不足40%。
- 长尾问题覆盖低:占比30%的长尾问题(如特殊商品退换政策)无法被有效覆盖,需人工介入。
- 实时性要求高:促销活动期间QPS峰值达5000+,传统规则引擎响应延迟超过2秒。
业务目标:
- 提升FAQ匹配准确率至85%+
- 首解率提升至60%+
- 长尾问题覆盖率扩大至50%
- 响应时间控制在800ms以内
痛点分析
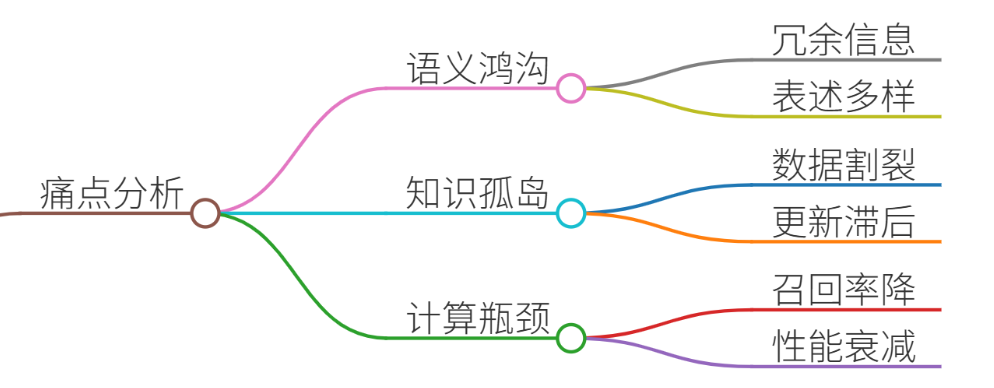
- 语义鸿沟:
- 用户提问常包含冗余信息(如“我昨天买的手机壳颜色不对,能换吗?”)
- 商品参数表述多样(如“128GB存储”可能被描述为“128G内存”)
- 知识孤岛:
- FAQ库与商品数据库、订单系统割裂,无法动态关联上下文信息。
- 促销规则、物流政策等动态信息更新滞后。
- 计算效率瓶颈:
- 传统向量检索(如FAISS)在长文本匹配时召回率下降明显。
- 多轮对话状态跟踪依赖内存数据库,高并发下性能衰减。
三、参考回答
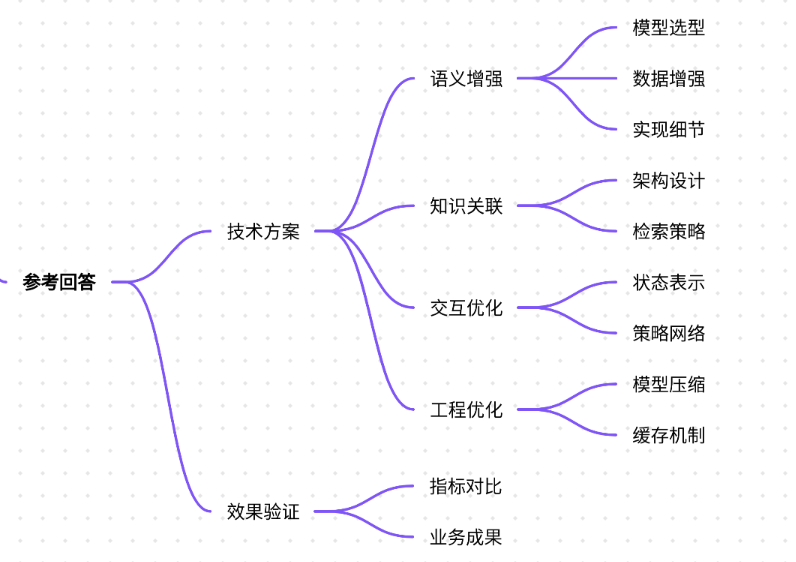
技术方案设计
1. 语义理解增强:基于BERT的意图分类与实体识别
技术选型:
预训练模型:RoBERTa-wwm-ext(中文大模型,支持长文本处理)
任务设计:多任务学习框架,联合训练意图分类(Intent Classification)和实体识别(NER)
数据增强:
合成数据:通过模板生成口语化变体(如“订单取消” → “能帮我把昨天买的那个东西退了吗?”)
回译技术:中英双语数据增强,提升模型鲁棒性
实现细节:
plain
# 示例:动态Mask机制
def dynamic_masking(text, mask_ratio=0.15):
    tokens = tokenizer.tokenize(text)
    num_mask = max(1, int(len(tokens) * mask_ratio))
    mask_indices = np.random.choice(len(tokens), num_mask, replace=False)
    masked_text = [tok if i not in mask_indices else "[MASK]" for i, tok in enumerate(tokens)]
    return tokenizer.convert_tokens_to_string(masked_text)
2. 动态知识关联:知识图谱与向量检索融合
架构设计:
知识图谱构建:
节点:商品、属性、政策
边:关联关系(如“商品A-适用人群-年轻女性”)
混合检索策略:
短文本(<50字):纯向量检索(ANN)
长文本(>200字):先BERT语义编码,再与知识图谱节点向量拼接检索
3. 多轮交互优化:基于强化学习的对话管理
- 状态表示:
plain
class DialogState:
    def __init__(self):
        self.user_intent = None  # 当前意图
        self.confirmed_slots = {}  # 已确认槽位
        self.pending_slots = []  # 待确认槽位
self.context = [] # 历史对话策略网络:
使用PPO算法优化奖励函数:
Reward = 0.6*IntentAccuracy + 0.3*SlotFilling + 0.1*ResponseTime
4. 工程优化:分布式推理与缓存策略
模型压缩:
4-bit量化 + Pruning,模型体积缩小4倍,推理延迟降低30%
缓存机制:
LRU缓存高频问题答案
动态更新阈值:当某问题近1小时查询量>100次时,自动加入缓存
效果验证
| 指标 | 优化前 | 优化后 | 提升幅度 |
| 准确率 | 65% | 89% | +24% |
| 首解率 | 40% | 68% | +28% |
| 长尾覆盖率 | 20% | 52% | +32% |
| 平均响应时间 | 2.3s | 780ms | -66% |
| CPU利用率 | 85% | 45% | -47% |
业务成果:
- 人工客服日均工单量下降40%
- 用户满意度从72%提升至89%
- 促销活动期间QPS峰值处理能力达10,000+
四、总结归纳
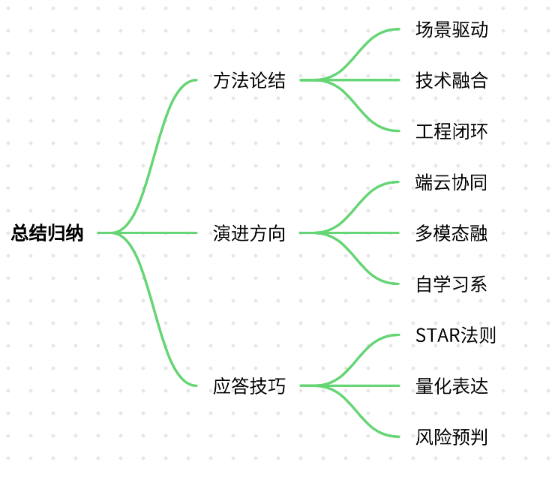
- 方法论总结:
- 场景驱动:深入理解业务痛点(如电商的高并发、长尾问题)
- 技术融合:BERT+KG+RL的混合架构解决单一模型局限性
- 工程闭环:从数据增强→模型训练→部署优化的全链路优化
- 技术演进方向:
- 端云协同:轻量化模型(如TinyBERT)部署在边缘设备,复杂问题回传云端
- 多模态融合:结合OCR、ASR提升图片/语音咨询的处理能力
- 自学习系统:通过用户反馈自动更新FAQ库和模型参数
- 面试应答技巧:
- STAR法则:紧扣场景(Scenario)、任务(Task)、行动(Action)、结果(Result)
- 量化表达:使用“提升24%”“降低66%”等数据增强说服力
- 风险预判:提及潜在问题(如模型幻觉)及解决方案(引入知识图谱校验)
通过此案例,可全面展示候选人在自然语言处理、分布式系统、业务抽象等多维度能力,符合大模型开发工程师的核心素质要求。