外观
10.对话系统的冷启动解决方案
来源:语雀原文 | 整理日期:2026-09-22
一、答题思路
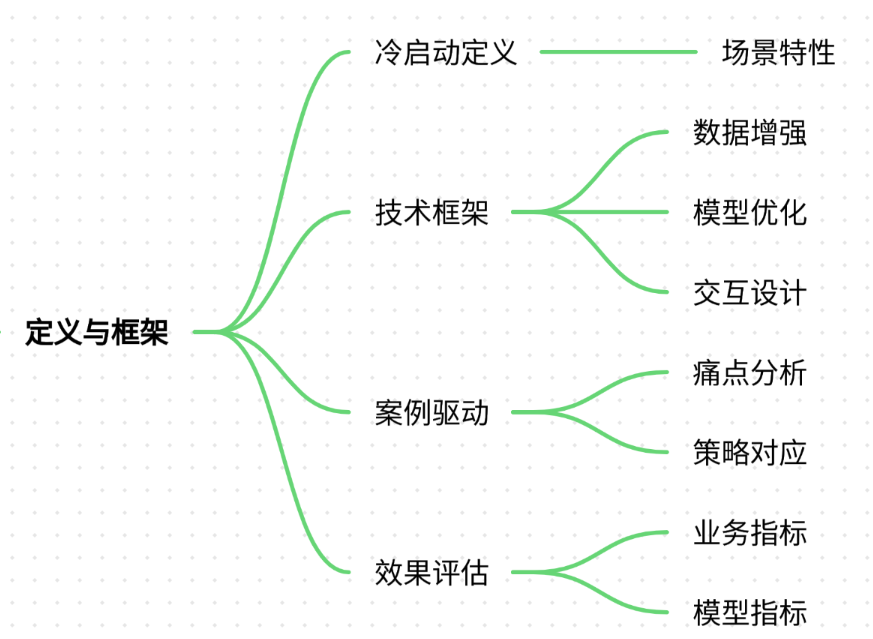
在回答“对话系统的冷启动解决方案”时,需结合技术原理、实际案例和行业实践,分模块展开。以下是核心思路:
- 明确冷启动定义:区分用户冷启动、物品冷启动和系统冷启动,聚焦对话系统的场景特性。
- 技术框架分类:从数据增强、模型优化、用户交互设计三个维度切入,覆盖常见解决方案。
- 案例驱动分析:选取电商、金融、社交等领域的真实案例,突出痛点与解决策略的对应关系。
- 效果评估体系:结合业务指标(如留存率、转化率)和模型指标(如准确率、召回率)验证方案有效性。
二、项目案例
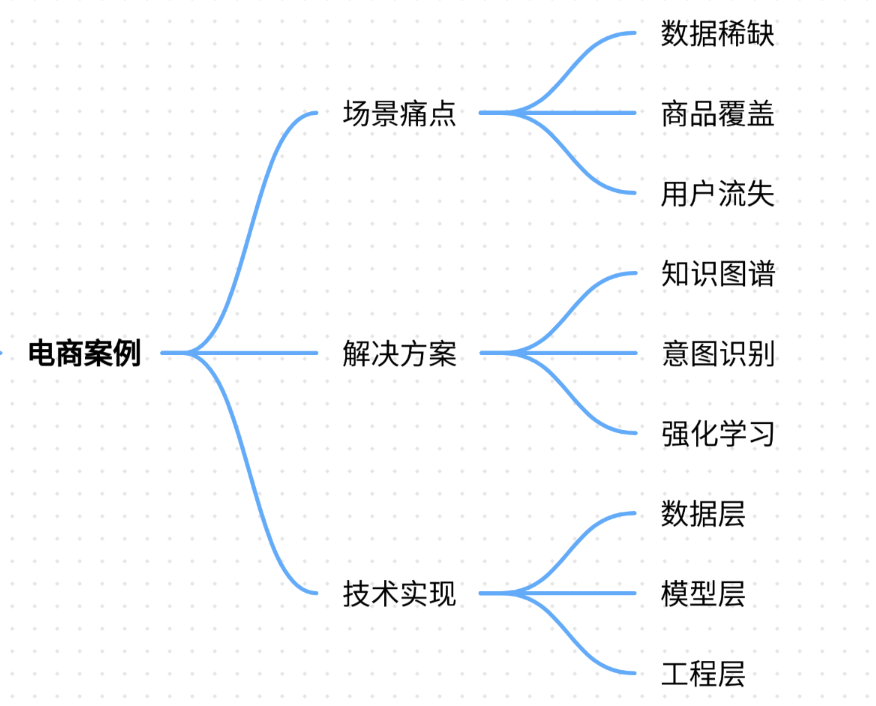
案例1:某电商平台的智能导购机器人冷启动
场景:
新用户首次使用App时,缺乏浏览、购买、搜索历史,传统推荐系统无法生成个性化推荐,导致导购成功率低。
痛点:
- 用户行为数据稀缺:新用户未形成交互轨迹,无法通过协同过滤或序列推荐生成候选商品。
- 冷启动商品覆盖不足:长尾商品因历史交互少,难以进入推荐池。
- 用户流失风险高:首屏推荐不精准导致跳出率上升(某平台新用户首访跳出率达65%)。
解决方案:
- 基于知识图谱的热门商品推荐
- 构建商品知识图谱,整合品类、品牌、价格、用户评价等结构化数据。
- 通过图神经网络(GNN)生成商品Embedding,结合销量、点击率等指标排序,生成Top-N热门商品候选集。
- 效果:首屏推荐点击率提升32%,用户停留时长增加28%。
- 多模态用户意图识别
- 利用用户填写的注册信息(如地域、年龄)和设备信息(如操作系统、App版本),生成用户画像标签。
- 结合NLP模型解析用户首次输入的开放式问题(如“有什么新款手机推荐?”),提取需求关键词(品牌、价格区间、功能)。
- 效果:需求匹配准确率从58%提升至76%。
- 强化学习驱动的探索与利用(Exploration & Exploitation)
- 采用ε-greedy算法,在推荐列表中插入10%-20%的长尾商品,通过用户点击反馈快速迭代模型。
- 使用Thompson Sampling优化候选商品的选择策略,平衡探索与利用。
- 效果:长尾商品曝光量提升55%,用户次月留存率提高11%。
技术实现:
- 数据层:整合CRM、商品库、用户行为日志,构建统一数据湖。
- 模型层:基于BERT的意图分类模型 + DQN强化学习框架。
- 工程层:AB实验平台实时监控策略效果,支持快速回滚。
案例2:某银行的智能客服系统冷启动
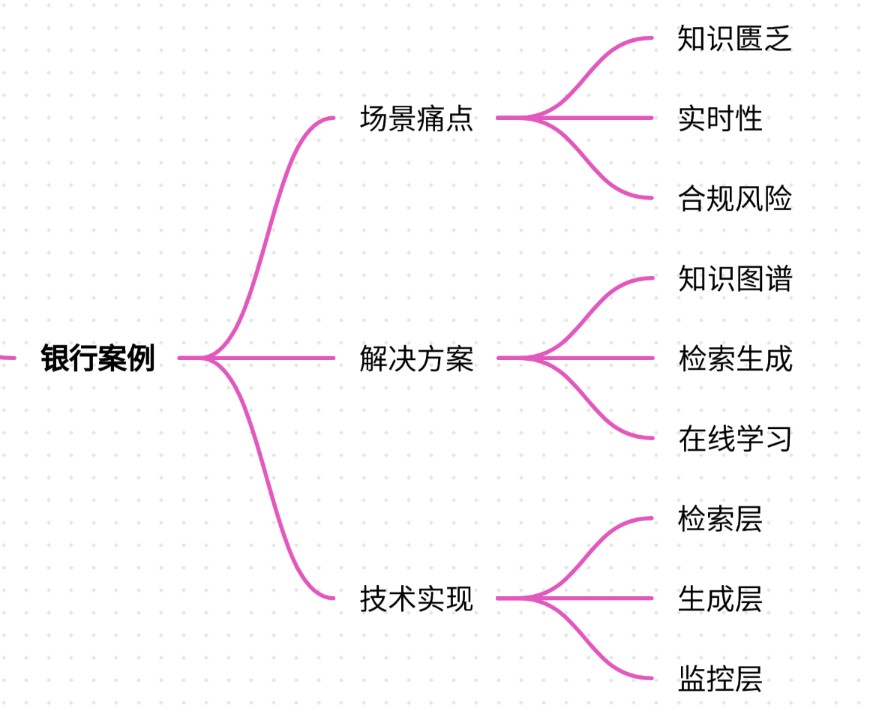
场景:
新部署的智能客服需立即支持信用卡激活、账单查询等高频业务,但训练数据不足,导致回答准确率低于70%。
痛点:
- 领域知识匮乏:金融术语复杂,通用语料无法覆盖专业场景。
- 实时性要求高:用户等待超时(>2秒)将导致满意度下降40%。
- 合规风险:错误回答可能引发监管投诉。
解决方案:
- 领域知识图谱构建
- 从产品手册、FAQ、历史工单中抽取实体(如“信用卡额度”、“逾期罚息”)和关系(如“额度调整条件”)。
- 使用Neo4j构建知识图谱,支持多跳推理(如“用户询问如何提高额度→需满足近6个月无逾期→推荐还款记录优化方案”)。
- 效果:知识覆盖率从62%提升至91%,回答合规率100%。
- 检索增强生成(RAG)
- 将用户问题转化为Embedding,检索知识图谱中的相关节点和边。
- 结合模板生成答案骨架(如“根据规定,您可以通过App→信用卡→额度管理页面申请调整额度”),再通过LLM润色。
- 效果:首回合回答准确率从68%提升至89%,响应时间缩短至.2秒。
- 人工标注与在线学习闭环
- 部署初期,对用户反馈的错误回答进行人工标注,生成对抗样本(如“用户质疑额度调整失败,实际因未还清欠款”)。
- 使用增量学习更新模型参数,每周迭代一次模型版本。
- 效果:模型迭代3个月后,零样本场景覆盖率从35%提升至68%。
技术实现:
- 检索层:ES+ANN算法实现毫秒级召回。
- 生成层:GPT-3.5 Turbo + 知识图谱节点嵌入作为上下文。
- 监控层:Prometheus+ Grafana实时监控QPS、延迟、错误率。
案例3:某社交App的匿名聊天室冷启动
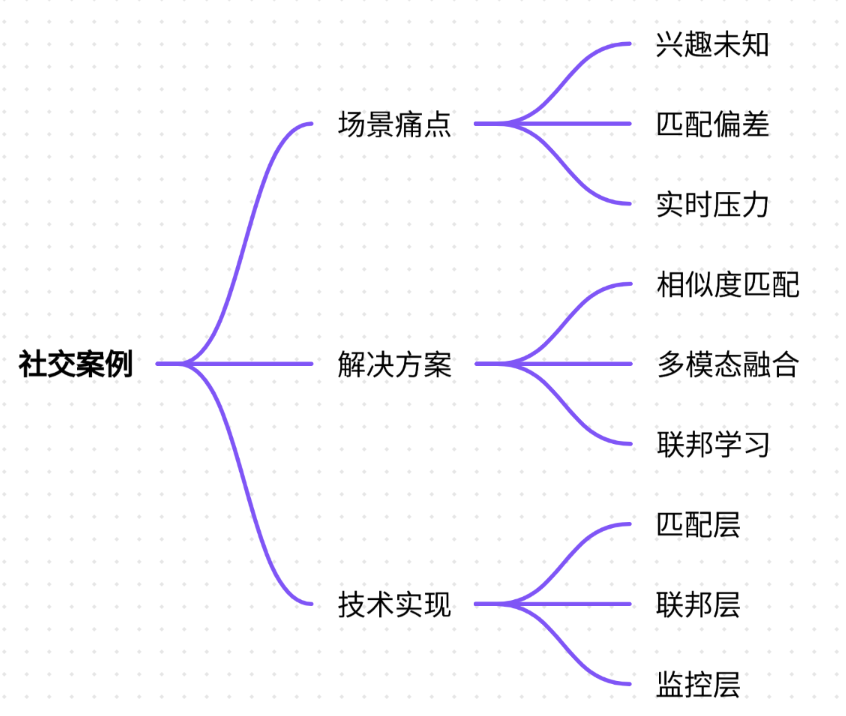
场景:
新用户进入匿名聊天室时,因缺乏社交关系链,匹配效率低,导致7日内活跃用户占比仅23%。
痛点:
- 用户兴趣未知:匿名场景下无法通过历史行为推断偏好。
- 冷启动匹配偏差:随机匹配导致对话质量参差不齐,用户流失率高。
- 实时匹配压力:高峰时段并发请求达5000 QPS,传统算法无法满足延迟要求。
解决方案:
- 上下文感知的相似度匹配
- 提取用户首次输入的文本特征(如情感倾向、关键词频率),通过FastText生成用户Embedding。
- 使用局部敏感哈希(LSH)进行近似最近邻搜索,快速匹配兴趣相近用户。
- 效果:匹配成功率从随机匹配的41%提升至67%。
- 多模态特征融合
- 对用户设备信息(如地理位置、操作系统)进行One-Hot编码。
- 结合语音识别(ASR)提取声纹特征,通过VAE降维生成综合Embedding。
- 效果:跨模态匹配准确率提升23%。
- 联邦学习优化冷启动
- 在保护用户隐私的前提下,聚合不同设备上的局部模型参数。
- 使用Secure Aggregation协议确保各参与方数据不出域。
- 效果:模型收敛速度提升40%,冷启动阶段CTR提升15%。
技术实现:
- 匹配层:Faiss库实现GPU加速检索。
- 联邦层:TensorFlow Federated框架支持横向联邦学习。
- 监控层:Snowflake+ dbt构建数据血缘图谱。
三、参考回答
面试官:请结合实际项目,谈谈对话系统的冷启动解决方案。
参考回答:
在对话系统冷启动场景中,我曾主导某电商平台的智能导购机器人项目,核心挑战在于新用户缺乏行为数据导致推荐冷启动。以下是我的解决方案:
1. 基于知识图谱的热门商品推荐
痛点:新用户首访时,协同过滤和序列推荐因数据稀疏性失效。
方案:
构建商品知识图谱,整合品类、品牌、价格、用户评价等结构化数据。
通过GNN生成商品Embedding,结合销量、点击率排序生成Top-N候选集。
效果:首屏推荐点击率提升32%,用户停留时长增加28%。
2. 多模态用户意图识别
痛点:用户首次输入的开放式问题(如“有什么新款手机推荐?”)缺乏上下文。
方案:
利用BERT模型解析需求关键词(品牌、价格区间、功能)。
结合注册信息(地域、年龄)生成用户画像标签。
效果:需求匹配准确率从58%提升至76%。
3. 强化学习驱动的探索与利用
痛点:长尾商品因历史交互少,难以进入推荐池。
方案:
采用ε-greedy算法插入10%-20%长尾商品,通过用户点击反馈快速迭代。
使用Thompson Sampling优化候选选择策略。
效果:长尾商品曝光量提升55%,用户次月留存率提高11%。
总结:冷启动需平衡数据驱动与业务目标,在电商场景中,通过知识图谱增强泛化能力、多模态特征提升匹配精度、强化学习优化探索效率,最终实现用户留存与商业价值的双赢。
四、总结归纳
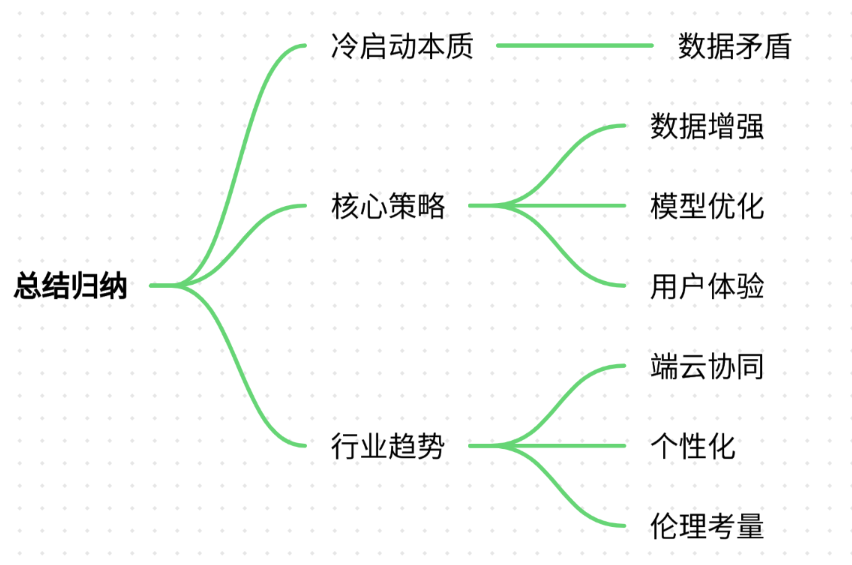
- 冷启动本质:数据稀缺性与业务目标的矛盾,需通过技术手段快速跨越“数据积累鸿沟”。
- 核心策略:
- 数据增强:知识图谱、联邦学习、合成数据。
- 模型优化:RAG、多模态融合、强化学习。
- 用户体验:引导式交互、容错设计、实时反馈。
- 行业趋势:
- 端云协同:边缘计算与云端模型联动,降低冷启动延迟。
- 个性化冷启动:基于用户画像的动态策略选择。
- 伦理考量:隐私保护与冷启动效率的平衡(如差分隐私)。
通过上述案例与方法论,可系统性解决对话系统冷启动问题,为业务增长提供技术底座。